Norsk forskning: Hva gjør norske organisasjoner med agentisk utvikling
Jan Henrik Gundelsby (Knowit) og Nils Brede Moe (SINTEF Digital) · JavaZone 2026, Room 5 Programsiden på JavaZone
Forskningsprosjektet KAIROS følger 15 team i 8 norske organisasjoner (blant dem Knowit, TV2, Storebrand, Politiet og Avinor) over fire år, i samarbeid med SINTEF Digital og Norges forskningsråd, for å forstå hva som faktisk skjer når AI-agenter tas i bruk – ikke bare hva vi tror skal skje. I juni 2026 samlet de i tillegg over 30 av Norges ledende utviklere, tech leads og forskere til to dager med åpne samtaler om det de ser, og det de ennå ikke forstår.
Jan Henrik åpner med en anekdote fra et marked i Marrakesh: han og familien kjøpte et håndlaget teppe, til tross for at maskinlagde tepper er raskere, billigere og "perfekte". Poenget: å finne menneskets plass når maskiner tar over intelligens og yrke er nettopp det foredraget handler om.
Foredraget er bygget rundt fire tema.
1. Tokenkost, modellkvalitet og suverenitet
Et konkret forskningscase (finansiert av EU, gjennomført hos Knowit) tok utgangspunkt i å forstå hva IT-markedet faktisk etterspør: over 1000 IT-kunngjøringer i 2026 alene ble analysert for å finne hvilke roller, teknologier og ferdigheter som etterspørres – kommunikasjonsevner kom ut som det klart mest etterspurte, på tvers av tekniske ferdigheter.
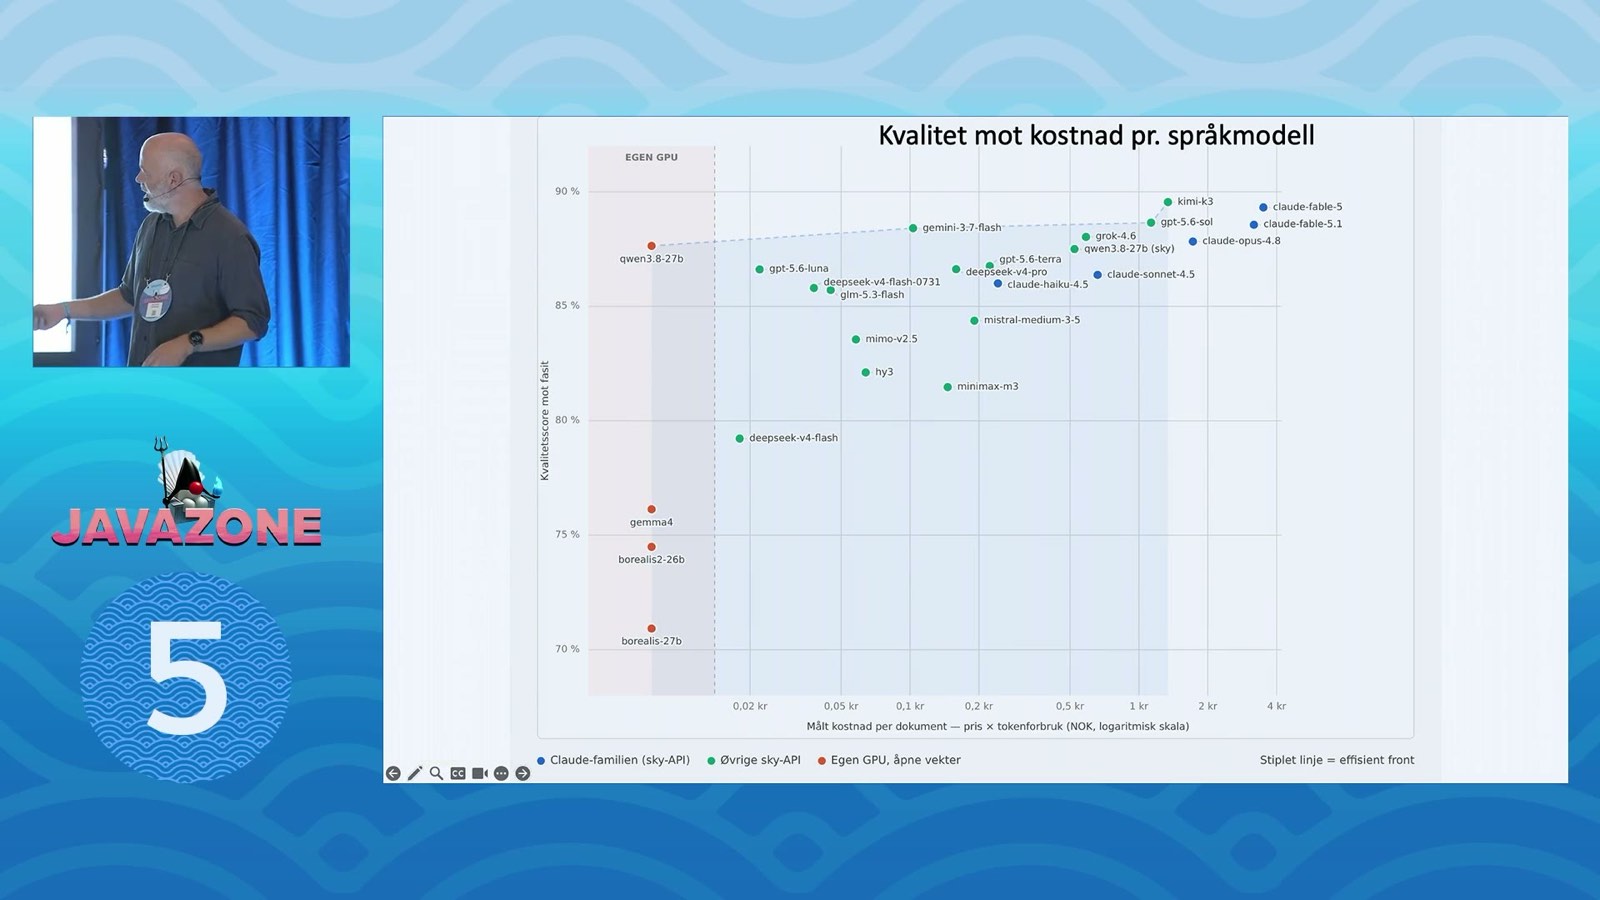
Samtidig evaluerte de 23 ulike språkmodeller mot 195 reelle anbudsdokumenter fra 2026, målt opp mot 13 menneskelig fasitsvar, strukturert med verktøy som DSPy og Pydantic.
Sentrale funn:
- Pris kan ikke sammenlignes per token alene. To modeller med lik listepris kan bruke dobbelt så mange tokens per dokument – den ene endte nesten dobbelt så dyr i praksis per dokument.
- Kontekst avgjør hva som betyr noe. I dette use-caset (batch-tolkning av anbud) var hastighet irrelevant, mens det er kritisk når du sitter og programmerer og trenger sanntids feedback.
- Kinesiske modeller (Kimi K3, Qwen) lå på eller over Pareto-fronten – billigere og bedre på norsk tekst enn enkelte vestlige alternativer i denne konteksten. En lokal Qwen 3-8-modell, kjørt på egen GPU, matchet frontier-modellene til praktisk talt null marginalkost.
- Konklusjon: å rigge seg for løpende evaluering av modeller er ikke spesielt vanskelig (agentene kan hjelpe deg å bygge det selv), men det kommer til å bli nødvendig for enhver virksomhet som vil ha kontroll på modellbruken sin – og redusere avhengigheten av de store amerikanske teknologileverandørene.
2. Second brain: kontekst som infrastruktur
Mennesker jobber med langt mer kontekst enn det som står i Jira og kodebasen – møter, samtaler med andre team, beslutningshistorikk. For at AI skal fungere godt trenger den tilgang på riktig kontekst, strukturert og gjort tilgjengelig – ikke bare mest mulig av den.
TØFF Digital (en av forskningspartnerne) bygde en "agentisk flyttebil" for å migrere eksisterende applikasjoner fra én AWS-plattform til en annen – mye lift-and-shift-arbeid som i utgangspunktet virker som en opplagt AI-oppgave.
flowchart LR
    subgraph Kilder["Spredt dokumentasjon"]
        Notion
        Wiki
        Slack
        GitLab_GitHub[GitLab / GitHub]
    end
    Kilder --> Indeksering["LLM-wiki: Markdown + indeksfil"]
    Indeksering --> Harness["Egen harness for flytting"]
    Harness --> Oppgaver["Konkrete, avgrensede oppgaver"]
    Oppgaver --> Progress["Progress-sporing på tvers av økter"]
    Harness --> Kjentefeil["'Kjente feil'-fil fra team-workshops"]
    Kjentefeil --> Harness
    Progress --> Laering["Sokratisk læringsmodus for teamet"]
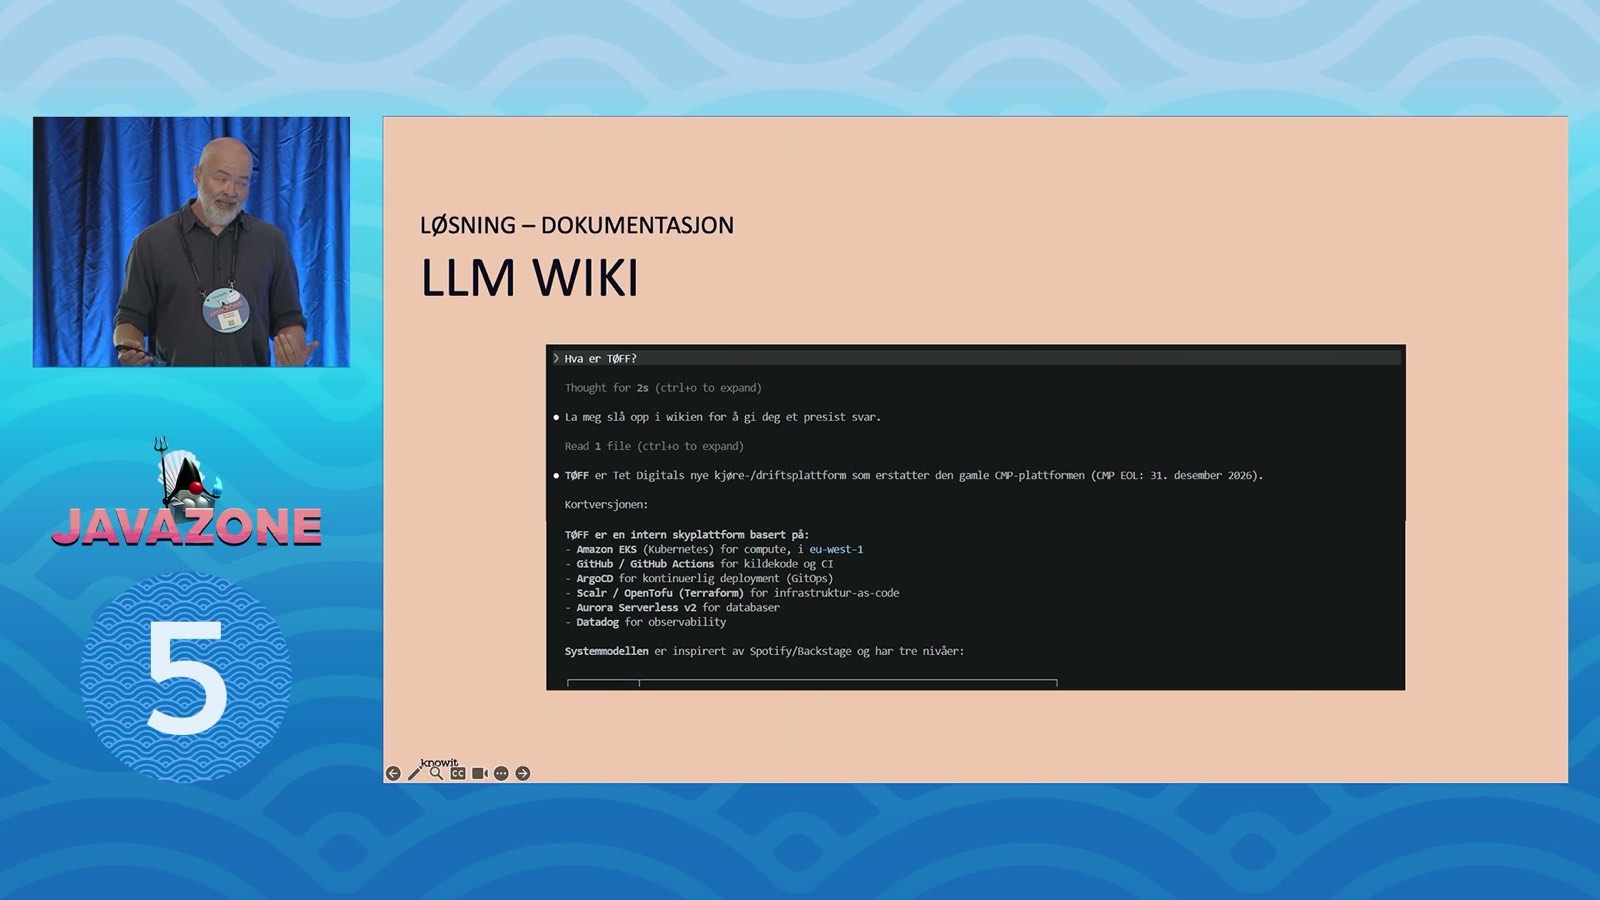
Løsningen deres på kontekstproblemet var det Andrej Karpathy har kalt en LLM-wiki: relevant dokumentasjon trekkes ut og legges i Markdown med en egen indeksfil foran, slik at en Claude-agent kan slå opp i indeksen og vite hvor den skal lete videre – i stedet for å gjette på interne forkortelser den aldri har sett.
To mål var like viktige som selve migreringen: at teamet beholder eierskapet og forstår hva de driver med, og at flyttebilen fungerer som et læringsverktøy – ikke bare automatisering. En egen "kjente feil"-fil, bygget fra workshops med teamene, fanger opp taus kunnskap agenten ikke finner selv. Tidlige funn: tokenbruken går ned over tid, men 80/20-regelen holder – de siste 20 % av jobben tar ofte like lang tid som de første 80 %, og det er fortsatt mennesker som må gjøre dem.
3. AI-adopsjon i team: syv faktorer som skiller
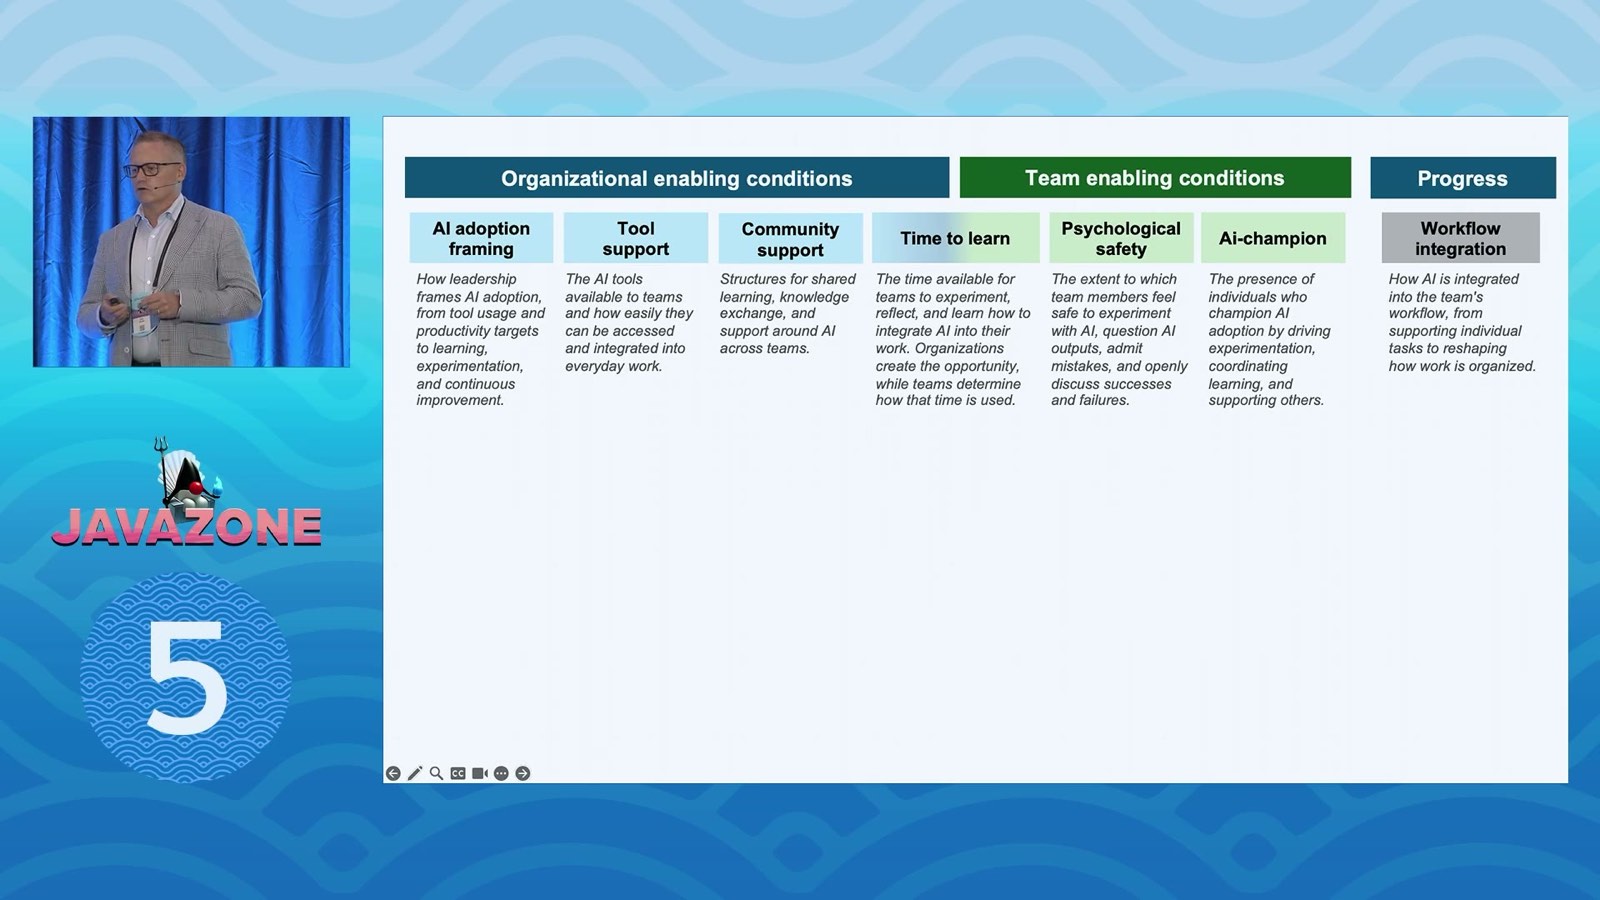
For to år siden fant forskerne enorme rapporterte produktivitetsgevinster på enkeltaktiviteter – men langt mindre forskjell når de så på hva teamene faktisk leverte. Konklusjonen: skal du få effekt av agenter, må du se på hele utviklingsprosessen, ikke bare kodeskrivingen. Gjennom spørreundersøkelser, observasjon, intervjuer og aksjonsforskning i 8–10 team identifiserte de syv faktorer som skiller teamene som kommer langt fra dem som ikke gjør det:
Noen funn som utfordrer intuisjonen:
- Motivasjon slår forventning. Team med et lærings-mindset ("nå skal vi eksperimentere") kom mye lengre enn team motivert av ren kostnadsreduksjon eller effektivitet fra dag én.
- Tid til å lære er kanskje den viktigste faktoren. Mange ledere spurte "kan ikke de ansatte lære dette på fritiden?" – men læring er en sosial prosess som må skje i og med teamet, ikke individuelt utenfor arbeidstid. Og læring uten endring i arbeidsprosessen er, per definisjon, ikke læring.
- Et internasjonalt selskap med gode verktøy og communities kom likevel ingen vei: konstant tidspress fra ledelsen ga null rom for å eksperimentere eller bli enige om guardrails.
- En bank fikk gode resultater raskt i teamet – men de rigide prosessene utenfor teamet (nødvendige, siden det handlet om hundrevis av millioner kroner) ble en ny flaskehals ledelsen måtte adressere.
- Et medieteam låste seg helt fast da en entusiast og en skeptiker ikke klarte å diskutere bruken åpent – og skeptikeren "fikk rett" da noe feilet i produksjon. Psykologisk trygghet, spesielt retten til å innrømme feil og stille dumme spørsmål, er blitt enda viktigere med agentisk AI enn den var før.
- Bruksintensitet er ikke gratis for samarbeidet. Jo mer AI brukes, jo mer individuelt jobber folk – selv om teamsamarbeid er en forutsetning for at det skal fungere i utgangspunktet. Noen team har bevisst dratt tilbake litt manuelt arbeid (som parprogrammering) fordi AI-bruken reduserte læringsmulighetene.
- Kontekst avgjør alvorlighetsgraden. Spørsmålet "hva hvis AI tar feil her, og betyr det noe?" bør stilles eksplisitt – svaret varierer enormt mellom sikkerhetskritiske systemer og eksperimentering, også internt i samme selskap og team.
4. Fremtidens team
Den gode nyheten: team kommer til å bestå. Men rollene blir mer overlappende – forskerne så et team der utviklere begynte å avlaste en presset designer med designoppgaver, noe som senket stressnivået og bedret flyten. I andre team oppleves det samme skiftet som en trussel i stedet.
To kompetanser peker seg ut som stadig viktigere: teknisk kompetanse rundt orkestrering av agenter, guardrails og modellvalg – og dyp produkt-, bruker- og domeneforståelse, siden gode spesifikasjoner til en AI krever at du faktisk vet hva du skal lage. Et åpent spørsmål forskerne selv strever med: hvordan blir juniorer til seniorer når junioroppgavene automatiseres bort? Parprogrammering er fortsatt en god praksis her.
Mindre, tverrfaglige team som eier en større del av verdikjeden – ikke bare en enkelt knapp i UI-et – ser ut til å bli mer effektive enn store team med mye koordinering. Det stiller nye krav til autonomi og raskere beslutninger, men også til teamstabilitet: nok identitet og eierskap til at teamet fungerer, balansert mot behovet for å hospitere og bytte fortere enn før.
Avslutning: tålmodighet, ikke akselerasjon
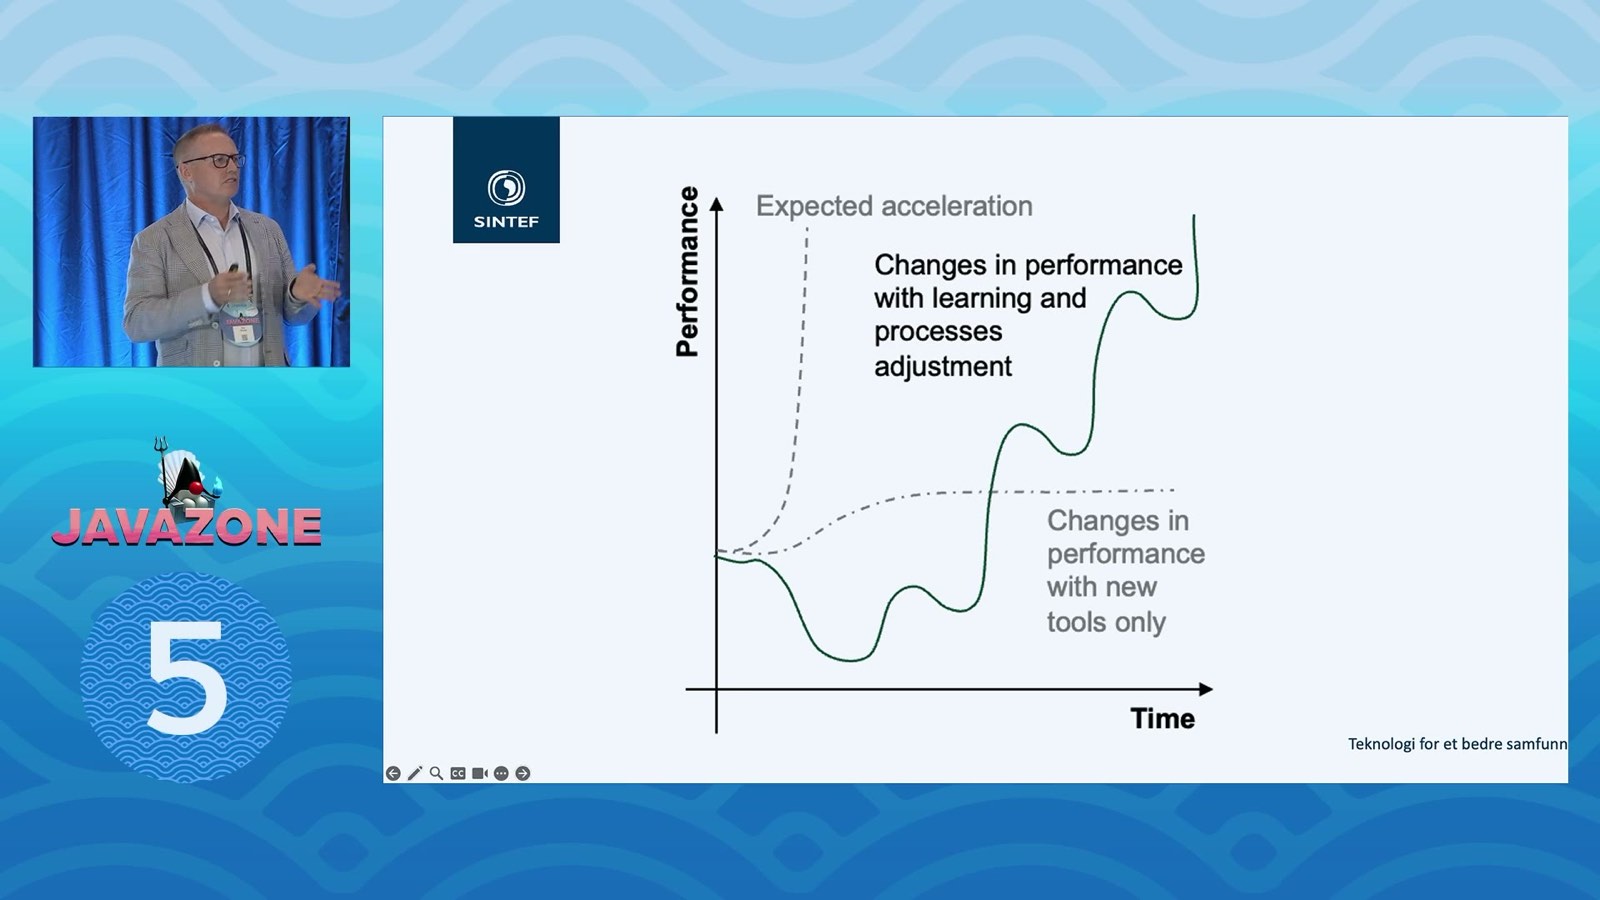
Mange ledere forventer en rett linje med kraftig akselerasjon. Det forskerne faktisk observerer i teamene som lykkes, er en kurve som først går ned mens teamet lærer og justerer arbeidsprosessene sine, før den tar av. Løper du videre uten å ta deg tid til den justeringen hver gang noe må endres, får du aldri ut effekten. Det er nettopp derfor dette er så interessant å forske på: det handler om teknologi, om mennesker, og om å endre arbeidsprosesser samtidig – og det kommer ikke til å slutte med det første.
Nøkkeltakeaways
- Kontroll over egen AI-plattform (evaluering, egne modeller, guardrails) blir stadig viktigere for å redusere avhengigheten av store leverandører.
- Strukturert, riktig kontekst (LLM-wiki, indekserte Markdown-filer) slår mer kontekst.
- Team er fortsatt viktig – jobb sammen og be om tilbakemelding tidlig, ikke når noe er "ferdig".
- Sett av reell tid til læring i arbeidet, sammen som team – ikke som en fritidsaktivitet for den enkelte.
- Forvent en dip i ytelse før effekten kommer. Farten på selve transformasjonen har en pris, og den prisen er tid til å justere underveis.