Bra tools, ubrukelige svar: Læring fra ett år med MCP
Bjørn Nordlund (Cisco) og Eirik Fagtun Kjærnli (Velo Labs, tidligere Accenture) · JavaZone 2026, Room 2 Programsiden på JavaZone
Det mest håndverksorienterte foredraget på denne siten: ett år med å bygge en MCP-server for administratorer som forvalter Cisco sitt globale møteromsutstyr (Webex-enheter, tidligere Tandberg) – i produksjon, i enterprise-skala, brukt av klienter som ChatGPT, Claude og interne agenter side om side. Konklusjonen deres er ikke at MCP er dødt, slik enkelte hevder, men at de færreste har måttet bygge slike løsninger i praksis ennå. Og når man gjør det, viser det seg raskt å handle om langt mer enn selve protokollen – det er, som de selv sier, «godt gammeldags API-design», bare med en ikke-deterministisk klient i andre enden.
Fra menneske-til-menneske til agentisk integrasjon
Cisco samler enorme mengder data fra møteromsutstyret sitt – rundt 2 millioner requests i minuttet på tvers av 100 000+ rom. Historisk har administratorer måttet navigere dette gjennom et fast grensesnitt ("Control Hub"), og enhver ny rapport eller arbeidsflyt krevde at noen bygget det som en dedikert funksjon. Drømmen som startet prosjektet: la kunder bygge videre selv, ved å eksponere data og funksjonalitet gjennom verktøy en agent kan bruke – uten at Cisco må forutse hvert spørsmål på forhånd.
Forskjellen fra tradisjonell integrasjon er at spørsmålet som kommer inn nå er vilkårlig, uten en forhåndsdefinert flyt, og aktøren i midten som skal løse det er en agent – egenutviklet, Copilot, Claude eller ChatGPT. Målet er å designe verktøyene slik at agenten ikke bare har riktig verktøy tilgjengelig, men faktisk klarer å bruke det riktig – for som de formulerer det: selv om agenten velger riktig verktøy, hjelper det lite hvis den bruker det feil.
Selvsikre svar som er feil, og hvorfor et godt søk slår paginering
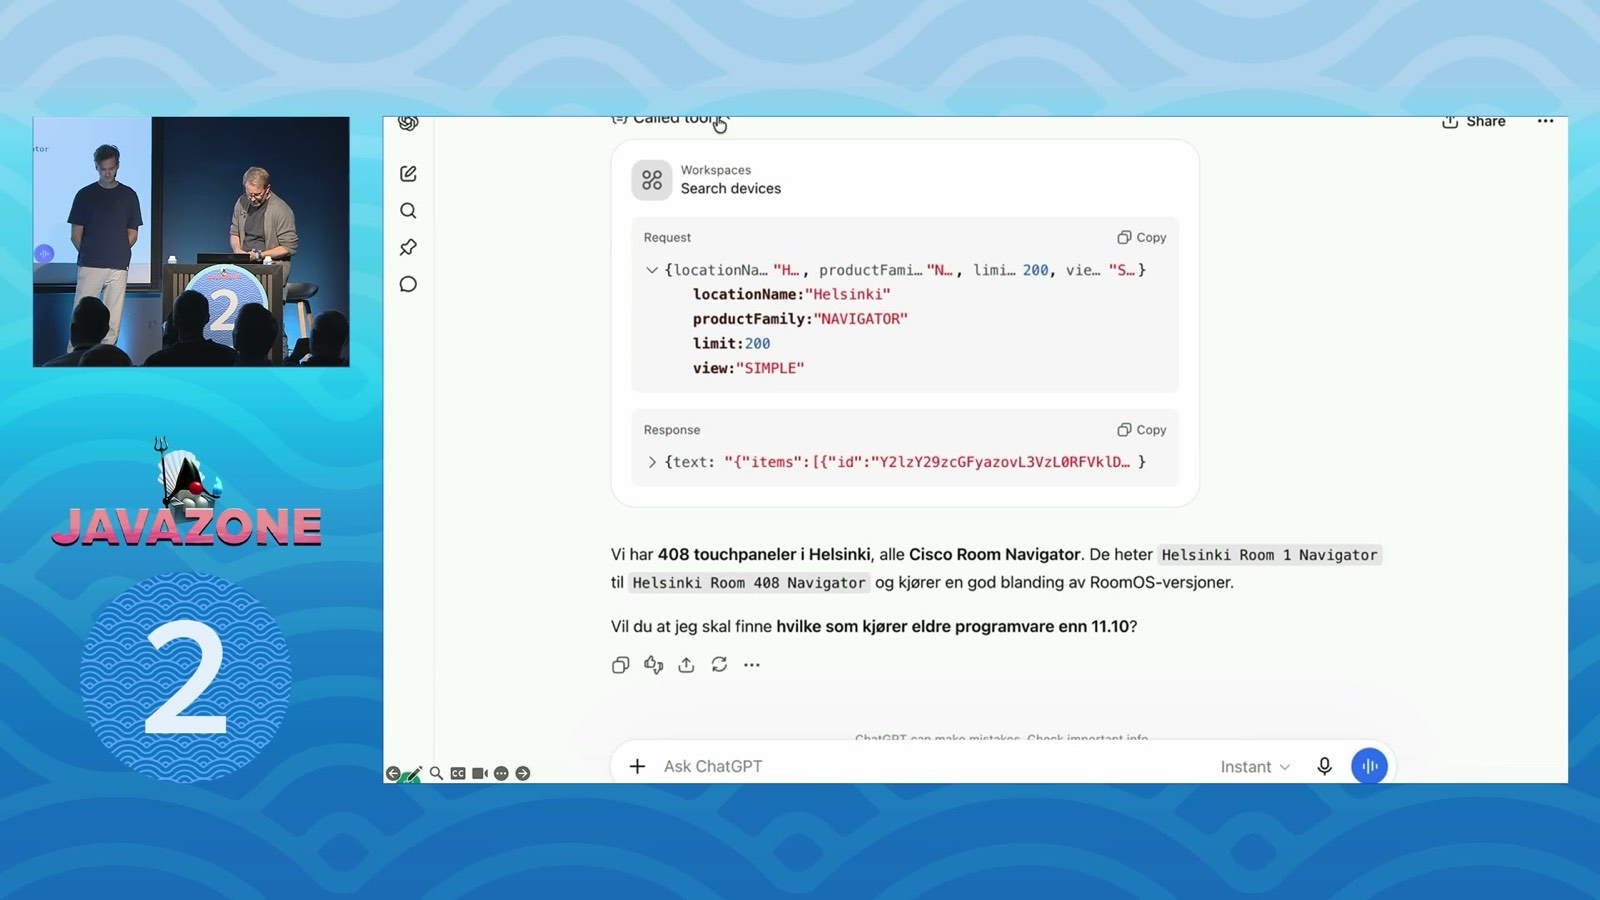
Det første eksempelet er talkens kjernepoeng. Et gammelt, velprøvd "list"-API med enkel filtrering og paginering får spørsmålet «hvilke touchpaneler har vi i Helsinki, og hvilke av dem kjører eldre programvare enn 11.10?». Agenten svarer – selvsikkert, presentabelt, og feil. Den hadde paginert gjennom første side (~100 av flere tusen enheter), funnet to programvareversjoner under 11.10 blant dem, søkt opp akkurat de to versjonene, og presentert et tall basert på et utvalg den aldri fikk vite var ufullstendig. Ingen bruker kunne ha oppdaget dette fra svaret alene.
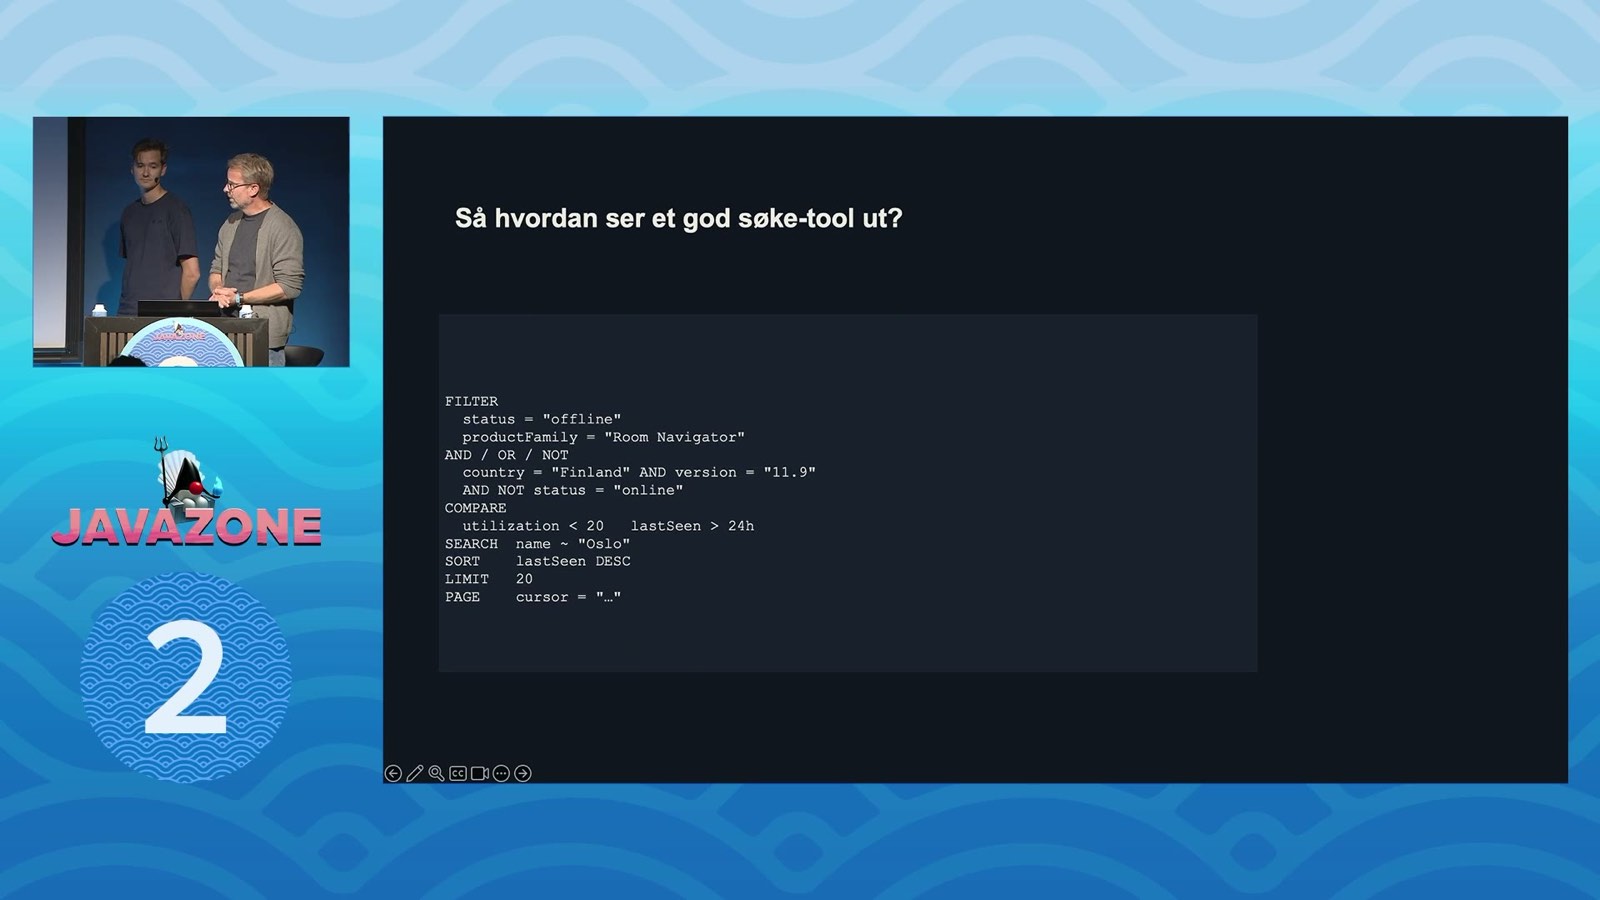
Løsningen deres var ikke bedre paginering, men et kraftigere søkeverktøy som kan uttrykke det brukeren faktisk spør om direkte – "ta programvare mindre enn 11.10" som et filter, ikke noe agenten må utlede selv gjennom gjentatte kall. De bygde et eget søkelag oppå flere underliggende datakilder, bevisst modellert etter Elasticsearchs spørrespråk – ikke fordi det er perfekt, men fordi agenter allerede er godt trent på SQL- og ES-lignende syntaks. Poenget generaliserer: ikke finn opp kruttet på nytt, lån et mønster modellen allerede kjenner.
Idiotsikre parametre, og feilmeldinger som en funksjon
Et gjennomgående tema: gjør parametrene dine umulige å misforstå. Ikke
size/offset som frittstående felt (size kan bety andre ting), men
paginering pakket i et eget objekt. Returner metainformasjon sammen med
resultatet ("100 av 34151, neste offset er X") – det koster nesten ingen
ekstra tokens og gjør det entydig for modellen hva den faktisk har fått.
Vær knallhardt konsekvent i navngivning på tvers av endepunkter (samme felt
het location ett sted og place et annet – nok til at modellen gjorde
feil), fordi en lengre kjede av kall er langt mer sårbar for tvetydighet
enn ett enkelt menneskelig blikk ville vært.
Den kanskje mest overførbare innsikten er å designe feil som en funksjon,
ikke en bug. Da et ugyldig lokasjonsnavn ("Lysaker") ga null treff (fordi
stedet faktisk het "Oslo Headquarter" i systemet), var svaret ikke en
generisk 404. MCP-konvensjonen er å returnere HTTP 200 med isError: true
i selve resultatet – protokollfeil er noe annet enn en agent-lesbar feil –
og feilmeldingen inkluderte konkrete forslag hentet fra et live oppslag i
databasen ("mente du: Oslo Headquarter?"). Med det på plass løste agenten
oppfølgingsspørsmålet helt uten at noen måtte fortelle den hvordan.
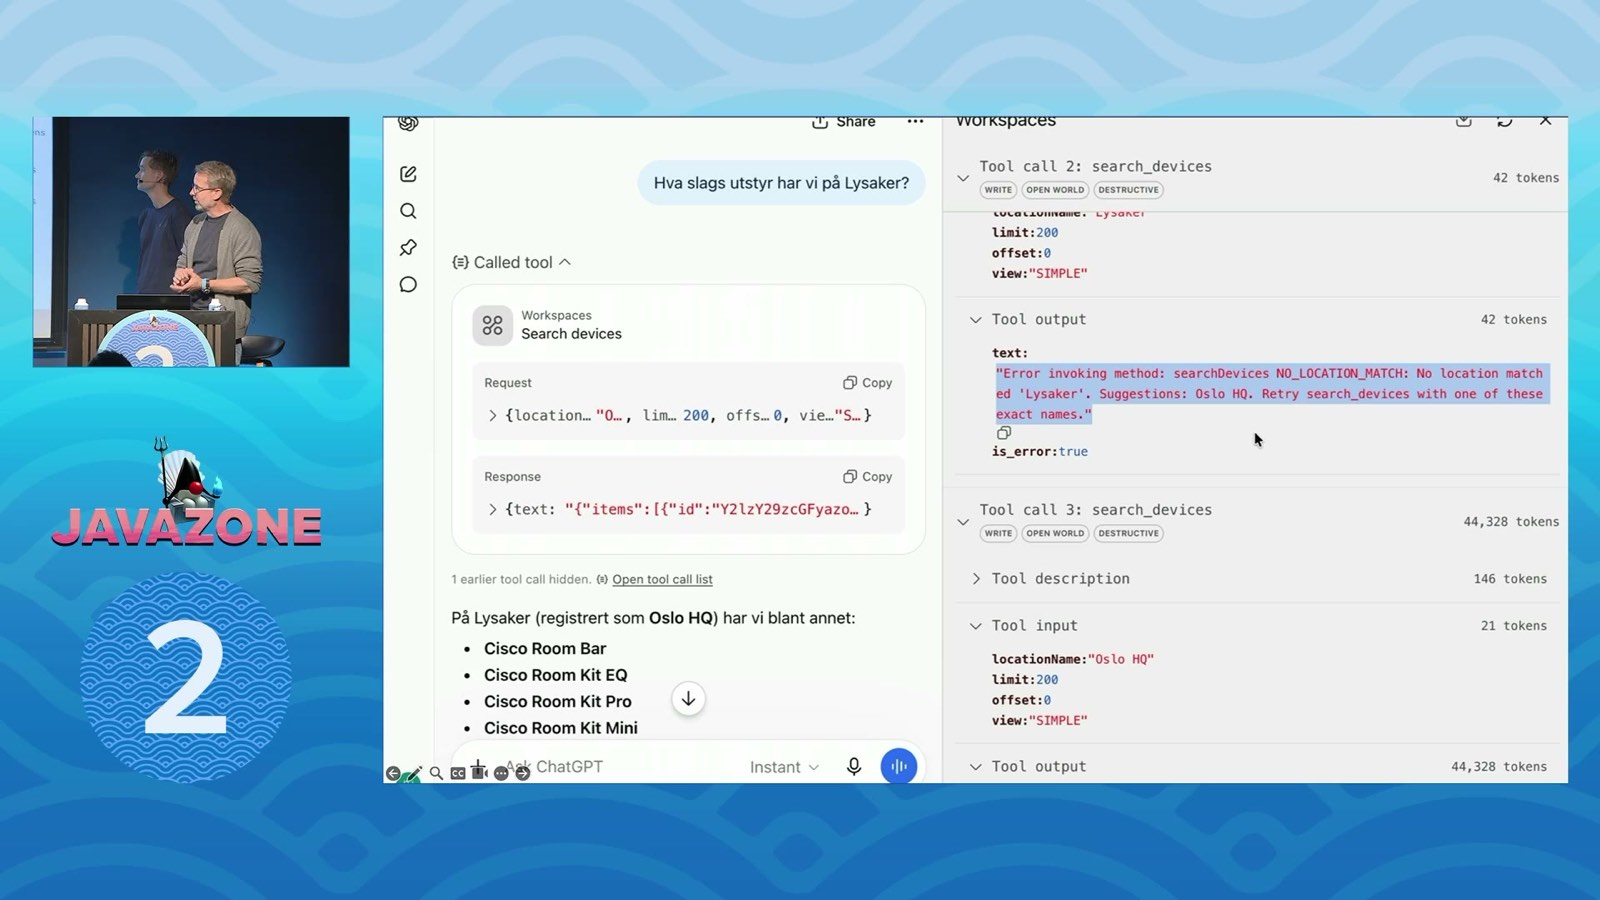
Skjermbildet over illustrerer også tokenkosten direkte: samme verktøykall som i utgangspunktet feilet endte opp på over 44 000 tokens for ett eneste tool-kall etter retry-forsøk – konkret tall på hvorfor kontekstbevisst design ikke er en estetisk preferanse, men en økonomisk nødvendighet i et system som skal skalere.
Når agenten ikke gir opp: aggregering og kontroll over datakilden
Et annet spørsmålstype avslører et rent skaleringsproblem: "hvor mange enheter har vi totalt?" mot en database med 150 000 rader. Uten et dedikert verktøy prøvde agenten å paginere seg gjennom alt – og brukte over 2 millioner tokens før de stoppet den manuelt. De skisserer tre alternativer: la agenten "bare kjøre" (skalerer dårlig, både i tokens og i belastning på kildesystemet), la agenten skrive og kjøre kode selv for å prosessere dataene før de går tilbake i kontekstvinduet (Anthropics eget råd etter at 2026-generasjonens agenter fikk kodeeksekvering), eller bygge dedikerte aggregerings-verktøy som flytter beregningen nærmere dataen – valget de landet på for de tyngste spørringene, informert av faktiske spørringslogger fra produksjon.
Skrivoperasjoner, MCP Apps og elicitation
For operasjoner som faktisk endrer noe, brukte de et preview/write-mønster: et preview-verktøy viser hva som vil skje og returnerer et token som binder sammen forhåndsvisningen med den påfølgende skriveoperasjonen – slik at write-verktøyet kan validere at det som utføres faktisk er det brukeren så.
Om MCP Apps (muligheten til å rendre egen grafikk inne i klient-chatten) er de forsiktig positive, men advarer mot overbruk: så snart du bygger en fast visning, tar du bort agentens frihet til å presentere dataen på den måten som faktisk passer spørsmålet – siden du ikke vet på forhånd hva brukeren har spurt om. Om elicitation (agenten kan be brukeren om mer informasjon interaktivt) er konklusjonen enda tydeligere: for få klienter støtter det ennå. En mulig forklaring er at MCP-protokollen var stateful frem til slutten av juli i år – noe som la betydelig kompleksitet på klientbyggere som ChatGPT og Claude – og først nå som protokollen støtter en stateless variant, er håpet at flere klienter følger etter.
Skills som ressurser – en agentside-idé flyttet til verktøysiden
Et forslag de selv trekker frem som eksperimentelt: skills as resources. Skills har historisk vært noe agent-byggere definerer på sin side (som i Midimeria-foredraget omtalt andre steder på denne siten), men Bjørn og Eirik foreslår å eksponere dem fra verktøysiden – som MCP resources (read-only markdown-filer agenten kan hente), ikke tools. En "hvordan gjøre en god facility review"-skill ligger da tilgjengelig for enhver klient som kobler seg til serveren deres, ikke bundet til én bestemt agentoppsett. Ideen er hentet fra en åpen diskusjon i FastMCP-prosjektets GitHub-repo, og de innrømmer at det gjenstår å få agenter til konsekvent å faktisk lese resources – historisk har de fleste klienter vært ensidig fokusert på tools.
Versjonering: et uløst problem i selve protokollen
Et konkret og ubehagelig funn: da de endret et parameternavn fra
location til locationName i en oppdatert versjon av MCP-serveren,
oppdaget de at ChatGPT ikke automatisk henter det nye skjemaet – klienten
må godkjenne skjemaendringer manuelt, noe som kan ta uker gjennom
offisielle kanaler. I mellomtiden feiler alle spørsmål brukeren stiller,
uten varsel.
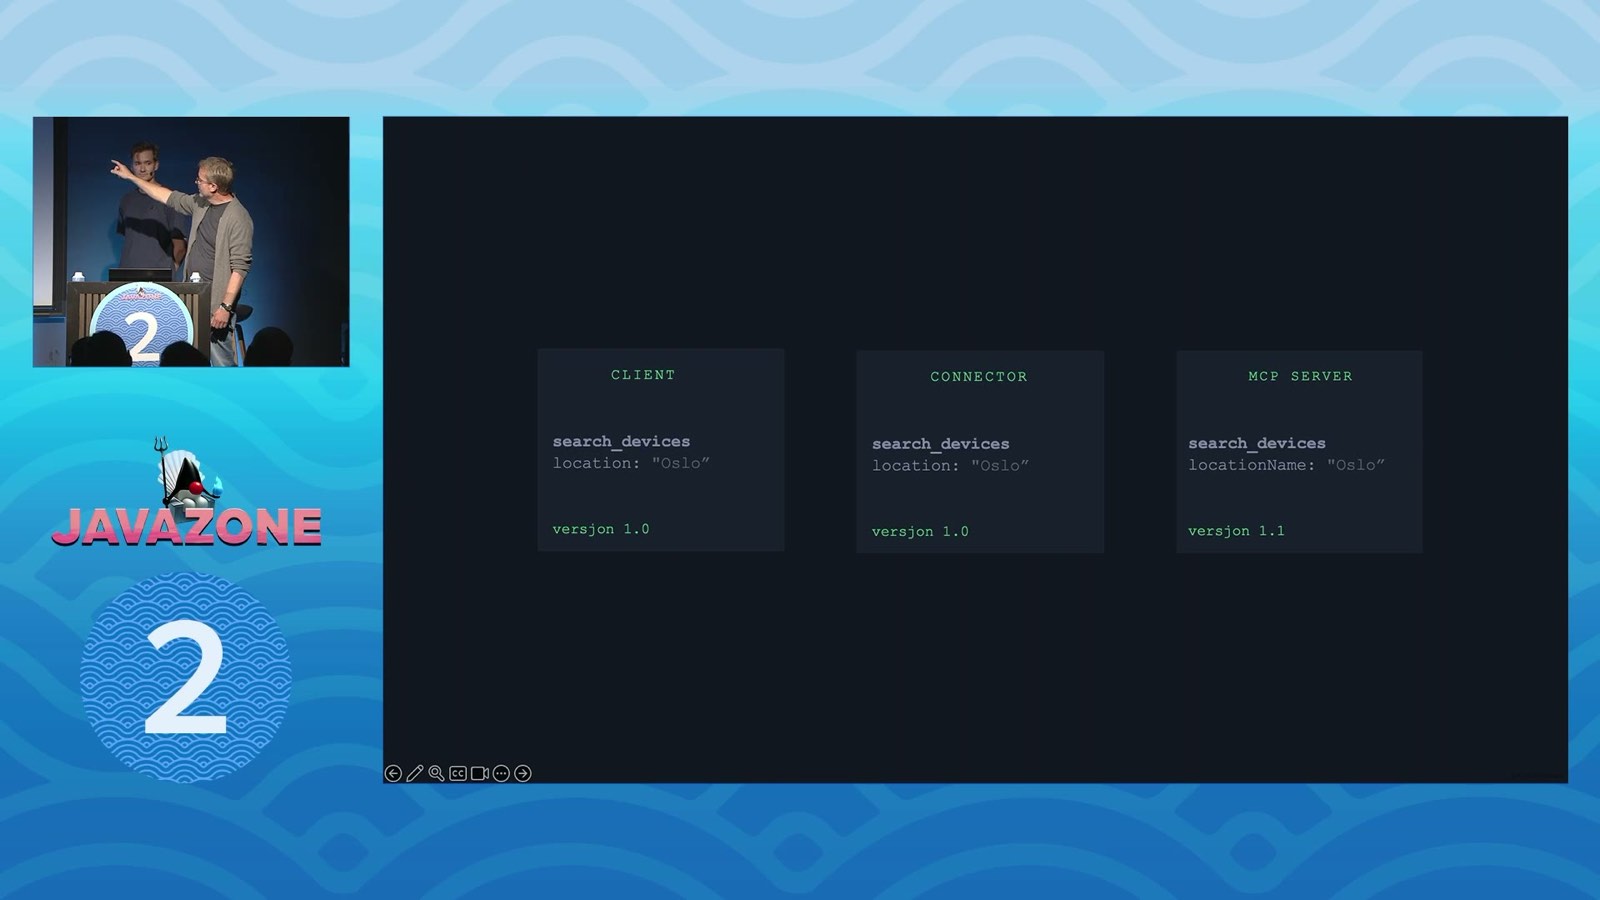
De påpeker at selve endringen sannsynligvis ikke var noe problem for agenten – den ville trolig funnet ut av det nye feltnavnet på egen hånd. Problemet er kontrollbehovet og cachingen hos klientene. Konklusjonen deres: dette er ikke løst i protokollen ennå, og praktisk policy akkurat nå er ganske enkelt å aldri gjøre breaking changes.
Ikke alle agenter er like gode
Et siste, ærlig poeng: det samme spørsmålet ("hva bør forholdet mellom 2-personers og 10-personers møterom være, basert på reell bruk?") gir vesentlig ulik kvalitet på svaret avhengig av hvilken agent som stiller det. En enklere, internbygget agent-harness endte på en overfladisk ratio-sammenligning; Claude Code gravde videre i sensordata om faktisk personantall i møtene og landet på en mer nyansert konklusjon som samsvarte bedre med hva Cisco selv observerer i praksis.
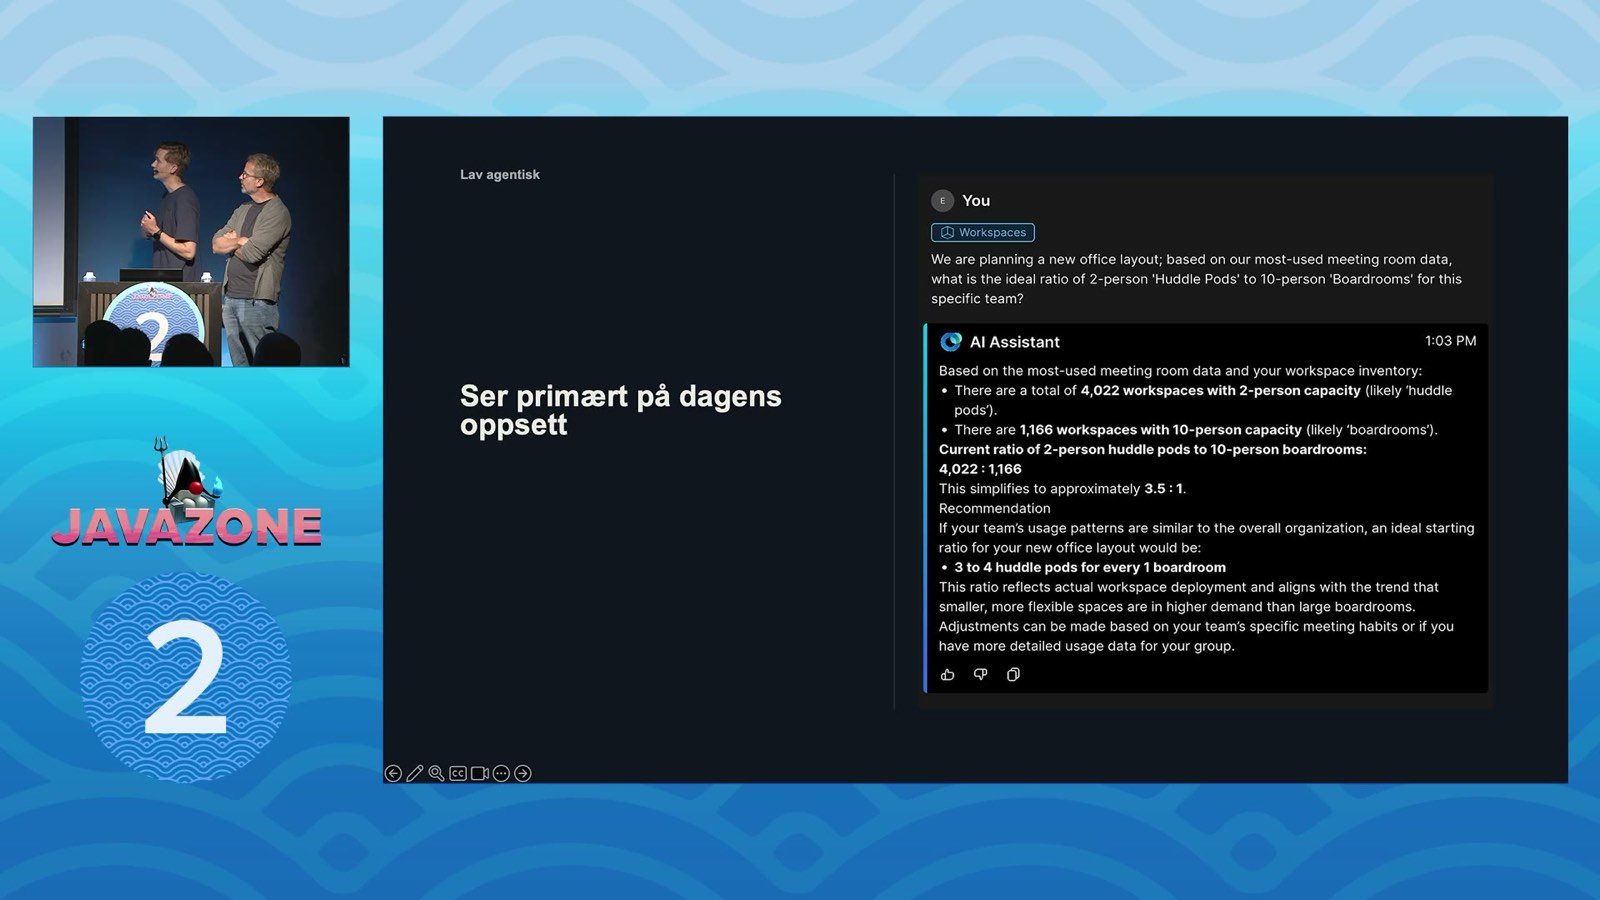
Implikasjonen for alle som bygger MCP-servere: du kan ikke teste mot én klient og anta resultatet generaliserer. Testing på tvers av agent-harnesser er, som de selv sier, "et helt eget tema" de ikke rakk å gå i dybden på – men et de eksplisitt flagger som nødvendig.
Nøkkeltakeaways
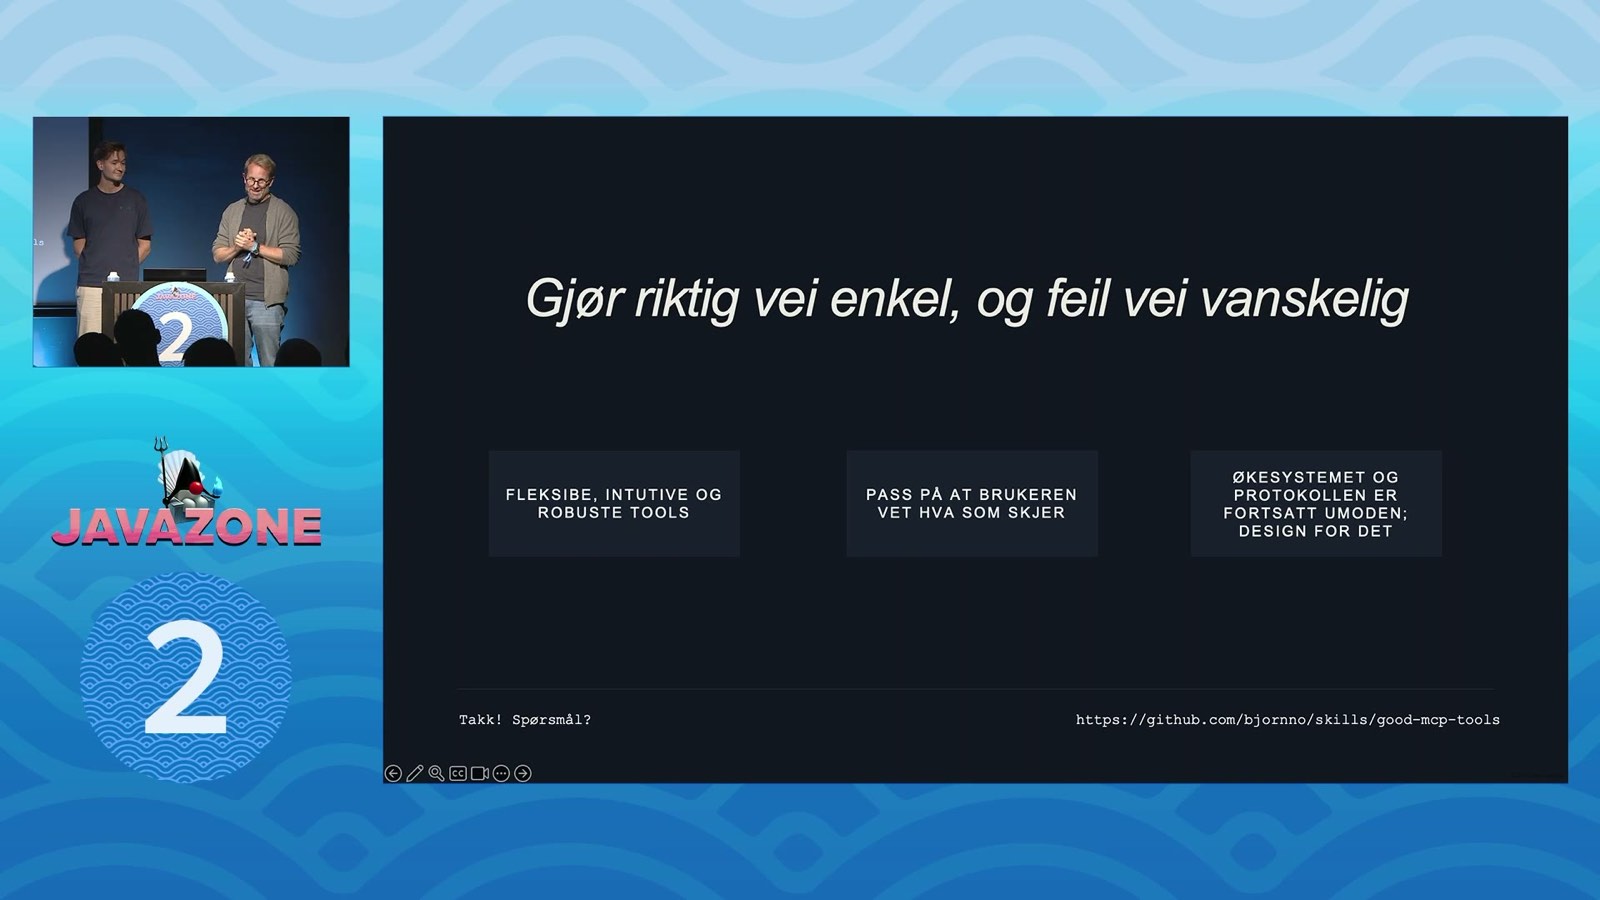
- Gode agent-verktøy er i stor grad godt, gammeldags API-design – idiotsikre parametre, konsekvent navngivning, og validering – bare med langt høyere kostnad for tvetydighet fordi feil forplanter seg gjennom en kjede av autonome kall.
- Et fleksibelt søkeverktøy som kan uttrykke brukerens faktiske spørsmål direkte slår paginering + agent-utledning hver gang – både i korrekthet og i tokenkost.
- Design feilmeldinger som en funksjon: konkrete forslag (hentet fra et live oppslag) lot agenten løse oppfølgingsspørsmål uten menneskelig hjelp.
- Tunge aggregeringer bør flyttes til dedikerte verktøy nær datakilden – ellers "løser" agenten det ved å paginere seg gjennom alt og bruke millioner av tokens.
- MCP-protokollen har fortsatt uløste problemer, spesielt rundt skjemaversjonering – klienter som ChatGPT oppdaterer ikke skjema automatisk, så praktisk policy er å unngå breaking changes helt.
- Samme MCP-server gir merkbart ulik svarkvalitet avhengig av hvilken agent/klient som bruker den – test på tvers av flere, ikke bare den du utvikler mot.
- Oppsummert i én setning: gjør det lett for agenten å velge riktig, og vanskelig for den å gjøre feil.