Mitt år med Claude: Building Midimeria
Øyvind Løkling (Mimeria Consulting) · JavaZone 2026, Room 3 Programsiden på JavaZone
Et helt annet perspektiv enn de organisatoriske erfaringsrapportene: én utvikler, ett sideprosjekt, ett år med Claude Code som hovedverktøy. Øyvind bygger Midimeria – en analyseplattform for musikkproduksjon – ved siden av konsulentjobben, og bruker prosjektet bevisst som et eksperiment i hvor langt agentisk utvikling kan strekkes mot en fullautomatisert utviklingssyklus. Konklusjonen hans er ikke at verktøyet er vanskelig å bruke godt, men at beslutte, delegere, verifisere – ferdighetene erfarne utviklere, produktledere og tech leads allerede har – er nøyaktig de samme ferdighetene som avgjør om du lykkes med agenter.
Konteksten er ikke ny, den er umerket
Øyvind starter med en påstand mange kjenner igjen fra andre talks på denne siten: siden alle bruker den samme modellen og den samme Claude Code-en, er det ikke modellen som skiller resultatene – det er hvordan du driver kontekstingeniørkunst: hvor mye kontekst du legger i det. Alle som spør Claude om et CRM, får "det samme" CRM-et tilbake. Differensieringen ligger i det du selv legger til.
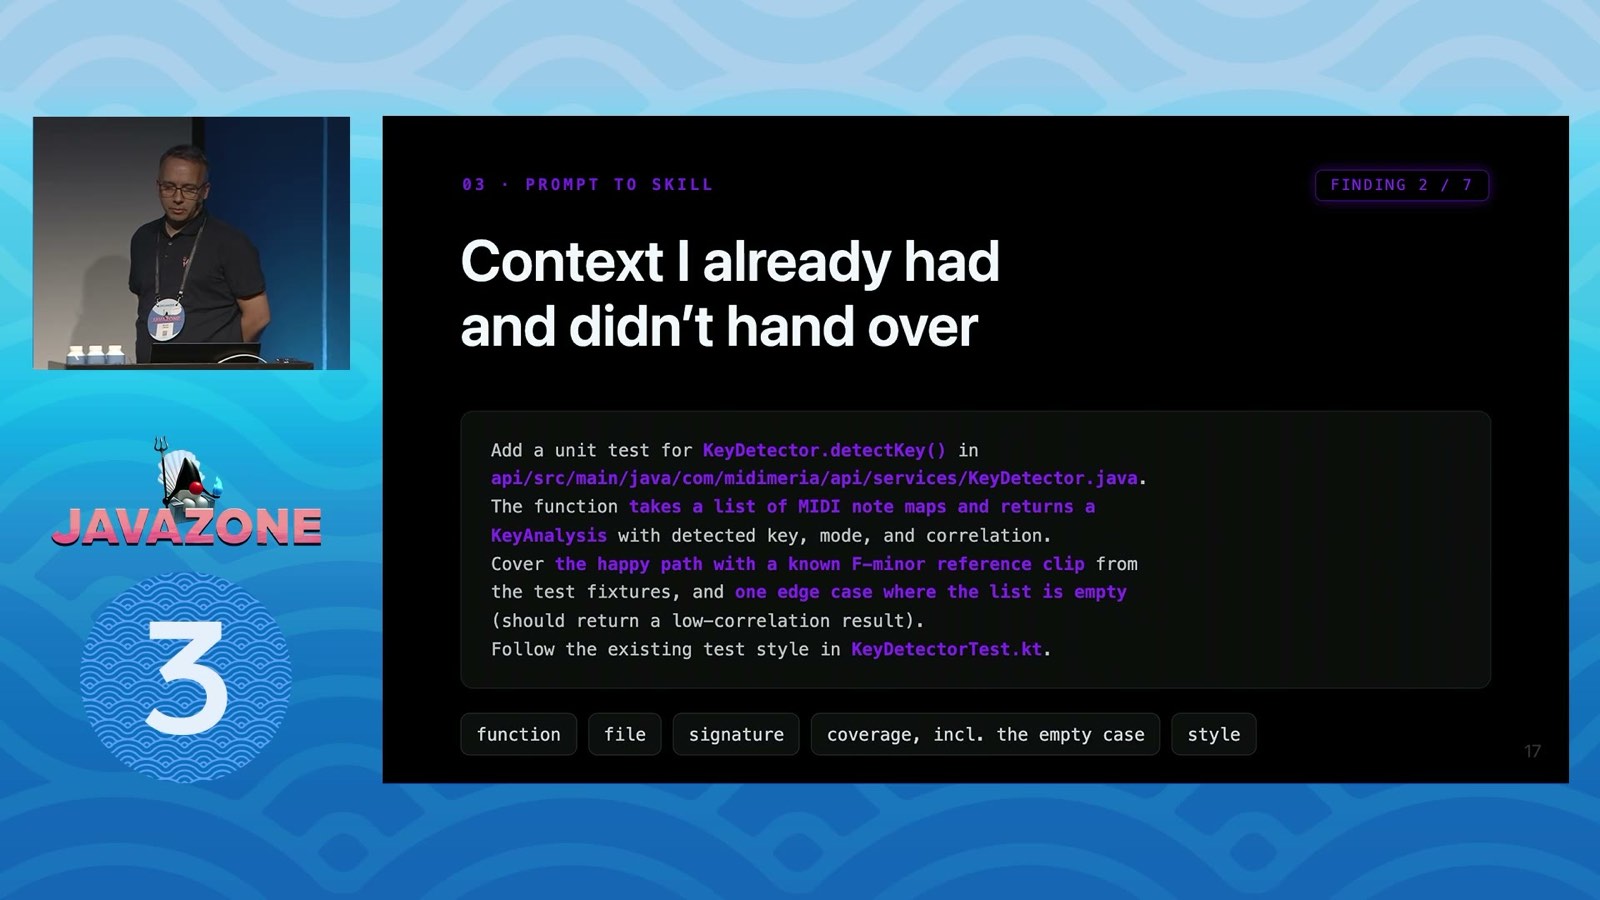
Det tydeligste eksempelet i talken er en side-ved-side sammenligning av to prompter for å legge til en test. Den korte varianten – "legg til en test for nøkkel-deteksjon" – gjorde at agenten stoppet og spurte om detaljer. Den lange varianten spesifiserte funksjon, fil, signatur, hvilken happy-path-case og hvilken edge case som skulle dekkes, og hvilken teststil som allerede fantes i kodebasen. Forskjellen mellom de to resultatene var rett og slett konteksten som forfatteren allerede hadde, men ikke ga videre.
Interessant nok legger han til et forbehold: med nyere modeller tror han han kunne klart seg med den enklere prompten – agentene blir riktig og slett flinkere til å stille de riktige oppfølgingsspørsmålene selv, på samme måte som man gir en seniorutvikler mindre kontekst enn en junior. Men å gi kontekst er fortsatt det billigste du kan gjøre for å sette ditt eget preg på resultatet.
En skill er en beslutning skrevet ned
Midimeria har vokst til rundt 30 "skills" – markdown-filer som koder inn konkrete, gjentakende beslutninger: rate limits, sikkerhetsnivå på nye tabeller, hvilke unntak som skal fanges hvor. Noen steder er han bevisst presis ("fang unntak ved disse grensene"), andre steder bevisst vag ("fang unntak ved passende grensesnitt") – fordi vag formulering lar agenten overføre regelen til situasjoner han ikke forutså selv.
Det ga et konkret utslag: en skill om å sjekke om bruker A kunne få tilgang til bruker B sin ID, skrevet uker tidligere, plukket opp av agenten midt i en ren refactoring-oppgave og fanget en reell sikkerhetsfeil dypt i koden – uten at sikkerhet var tema for oppgaven i det hele tatt.
Skillsene komponerer seg selv til det han kaller en ikke-deterministisk
graf: en toppnivå-skill (/linear-autopilot) trigger andre skills basert
på hva slags arbeid som dukker opp, ikke via en hardkodet arbeidsflyt.
flowchart TD
    A["/linear-autopilot<br/>(pull ticket, start work, loop)"] -.-> B[pr-checklist]
    A -.-> C[linear-manager]
    A -.-> D[deploy]
    B --> E[improve-tests]
    B --> F[test-coverage]
    D --> G[sre-check]
    D --> H[handoff]
    B -.-> G
    F --> I[discovered-issues]
    G --> I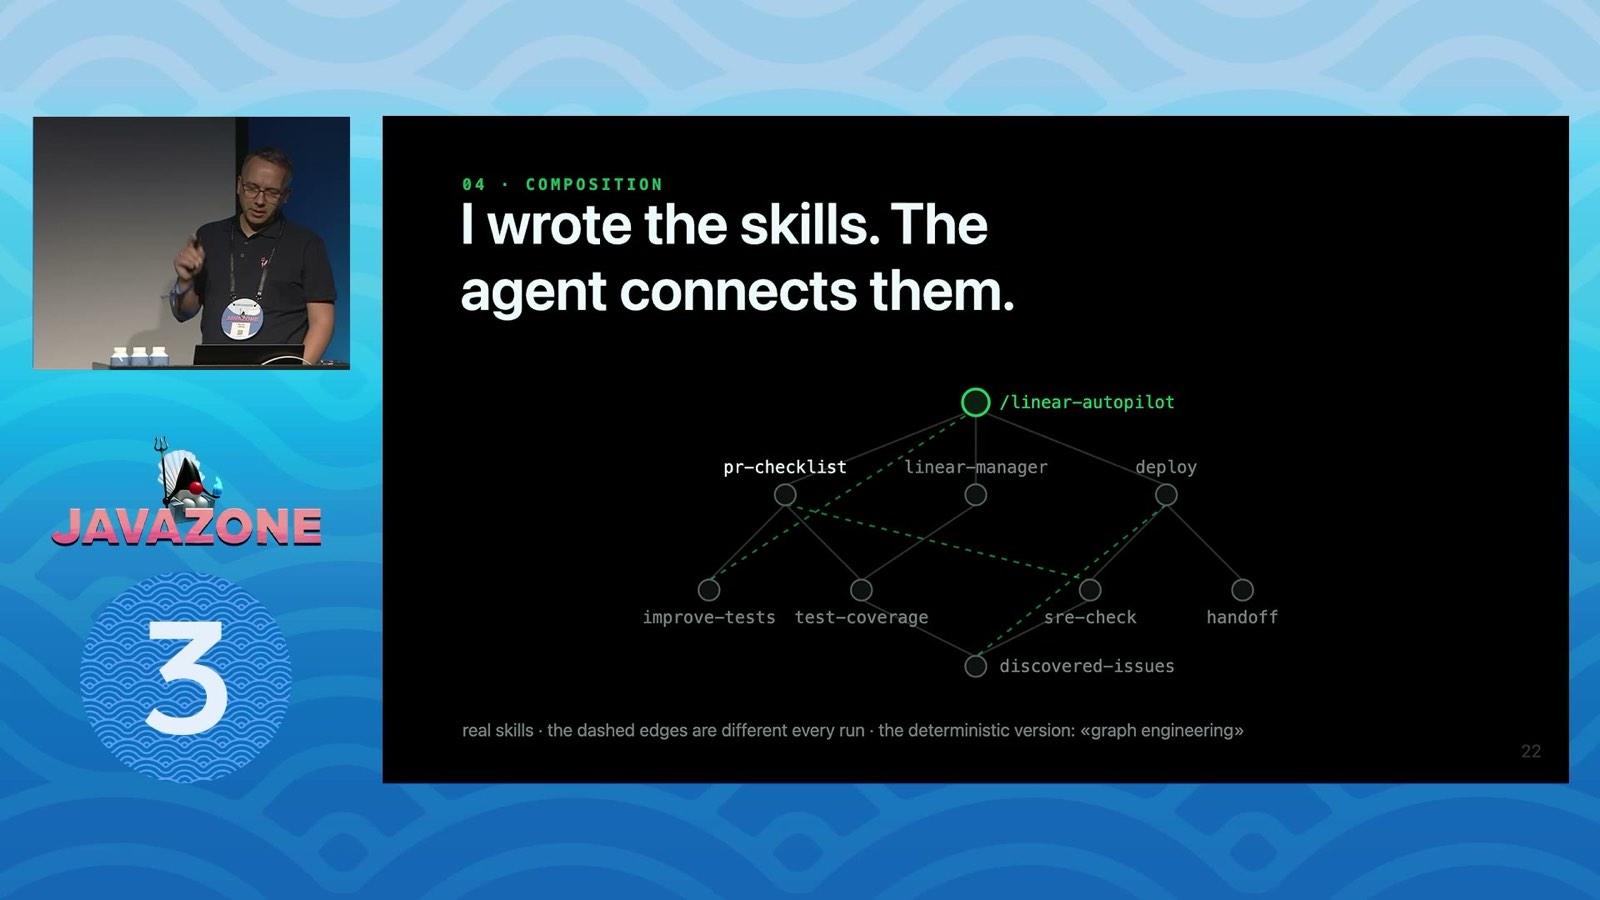
Han trekker eksplisitt en linje til "graph engineering" og Googles ADK – og avviser den retningen for eget bruk. Å prøve å fange en arbeidsflyt som en fast, forutsigbar graf minner ham om BPM (business process management): troen på at man kan modellere virkeligheten presist nok på forhånd. Den ikke-deterministiske varianten gir agenten samme rom for skjønn som en ansatt ville hatt – med den åpenbare bakdelen at agenten noen ganger rett og slett dropper et steg ("beklager, rakk ikke sjekklisten denne gangen"). Løsningen er den samme som for mennesker: det du absolutt må ha gjort hver gang, gjør du om til en git-hook, ikke en forventning til agentens dømmekraft.
Fra prompting til å fange kunnskap systematisk
Et sidespor som fortjener egen oppmerksomhet: å bruke en LLM som "bibliotekar" for egne notater (obsidian-filer skrevet i markdown), som trekker ut konsepter og likheter på tvers av notatene dine. Øyvind nevner at Google publiserte et paper om "Weeky Skills" rett før JavaZone, som bruker samme idé til noe mer avansert: agenten noterer sine egne feilmønstre og bruker dem til å forbedre skillsene sine selv over tid. Det er et beslektet konsept til "second brain"-ideen fra KAIROS-forskningen omtalt andre steder på denne siten – bare anvendt av én person på sitt eget prosjekt, ikke av et helt team.
Ett annet lettvekts-råd med stor effekt: gi agenten en eksplisitt lov til å gi opp. En skill som sier at agenten kan stoppe og melde fra hvis den ikke ser en vei videre, reduserte hallusinasjoner merkbart – fremfor at den spinner videre og finner på noe for å virke ferdig.
Natt-loopen, og når den lyver
Med tillit bygget opp over tid satte Øyvind opp et sikret miljø – en Kubernetes-runtime med Docker og en isolert Windows-instans som kjører Ableton – brannmuret, men med internettilgang, slik at han kan SSH inn og overta en økt som har kjørt i timevis, hvor som helst fra.
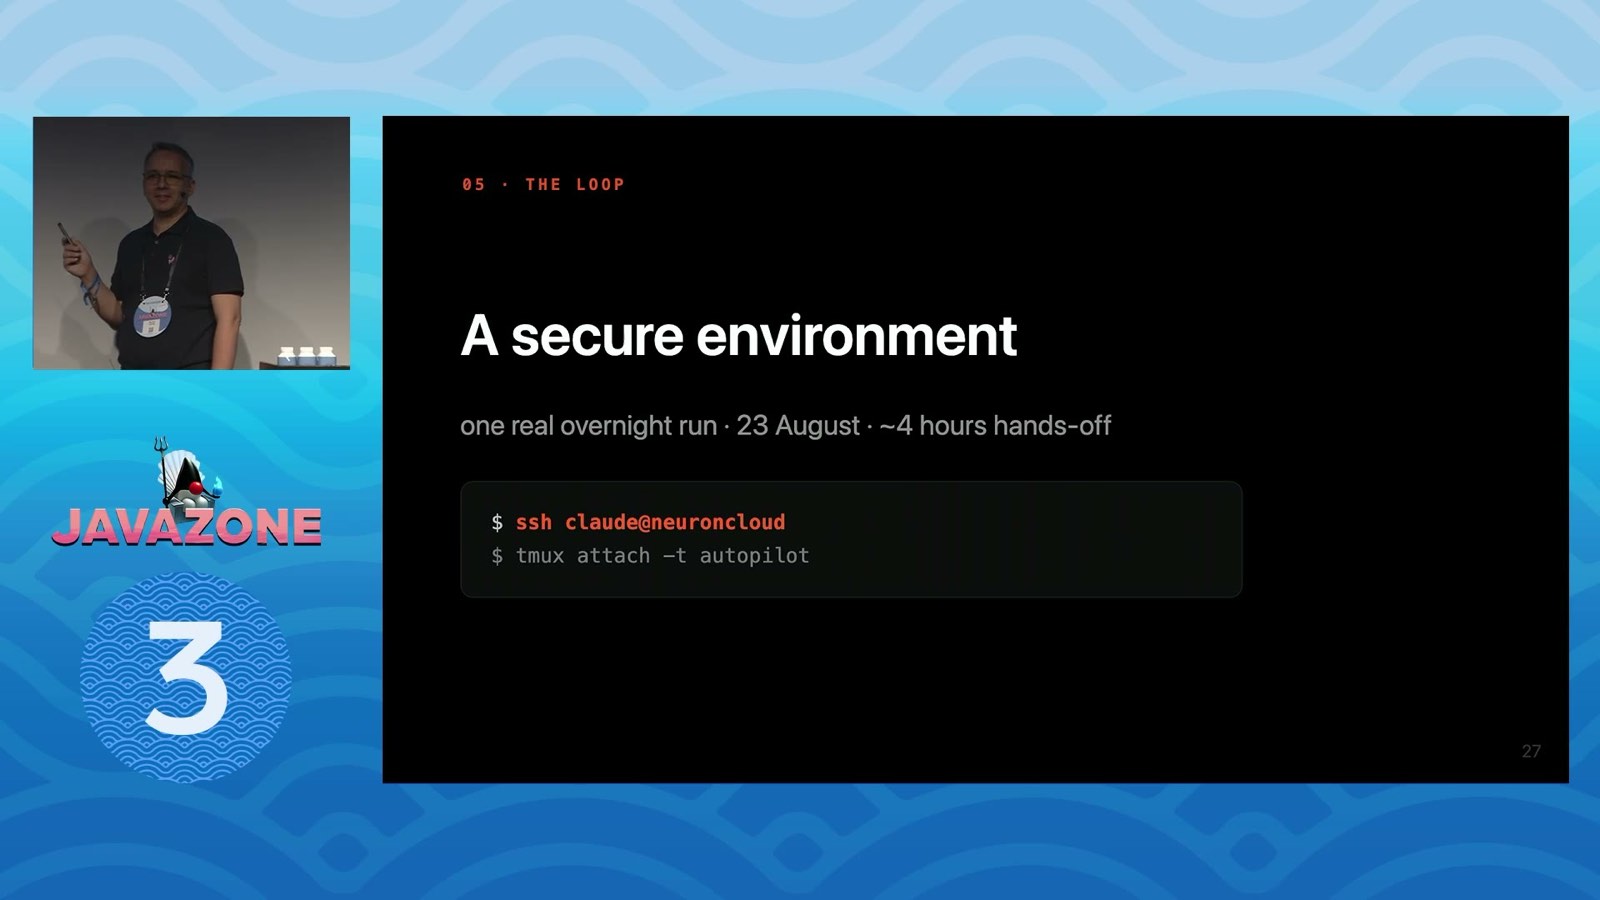
Systemet kjørte i økende varighet, fra rundt en time ved juletider til fire til seks timer nå – ikke fordi agenten ble bedre, men fordi flaskehalsen flyttet seg: koden ble skrevet raskt nok til at produktbeslutningene ikke fulgte med. Samtidig dukket det opp konkrete hallusinasjoner: en loggført påstand om "5023 tester bestått, commit-hash, PR #1479 merget" – der ingen av delene fantes verken på disk eller i GitHub.
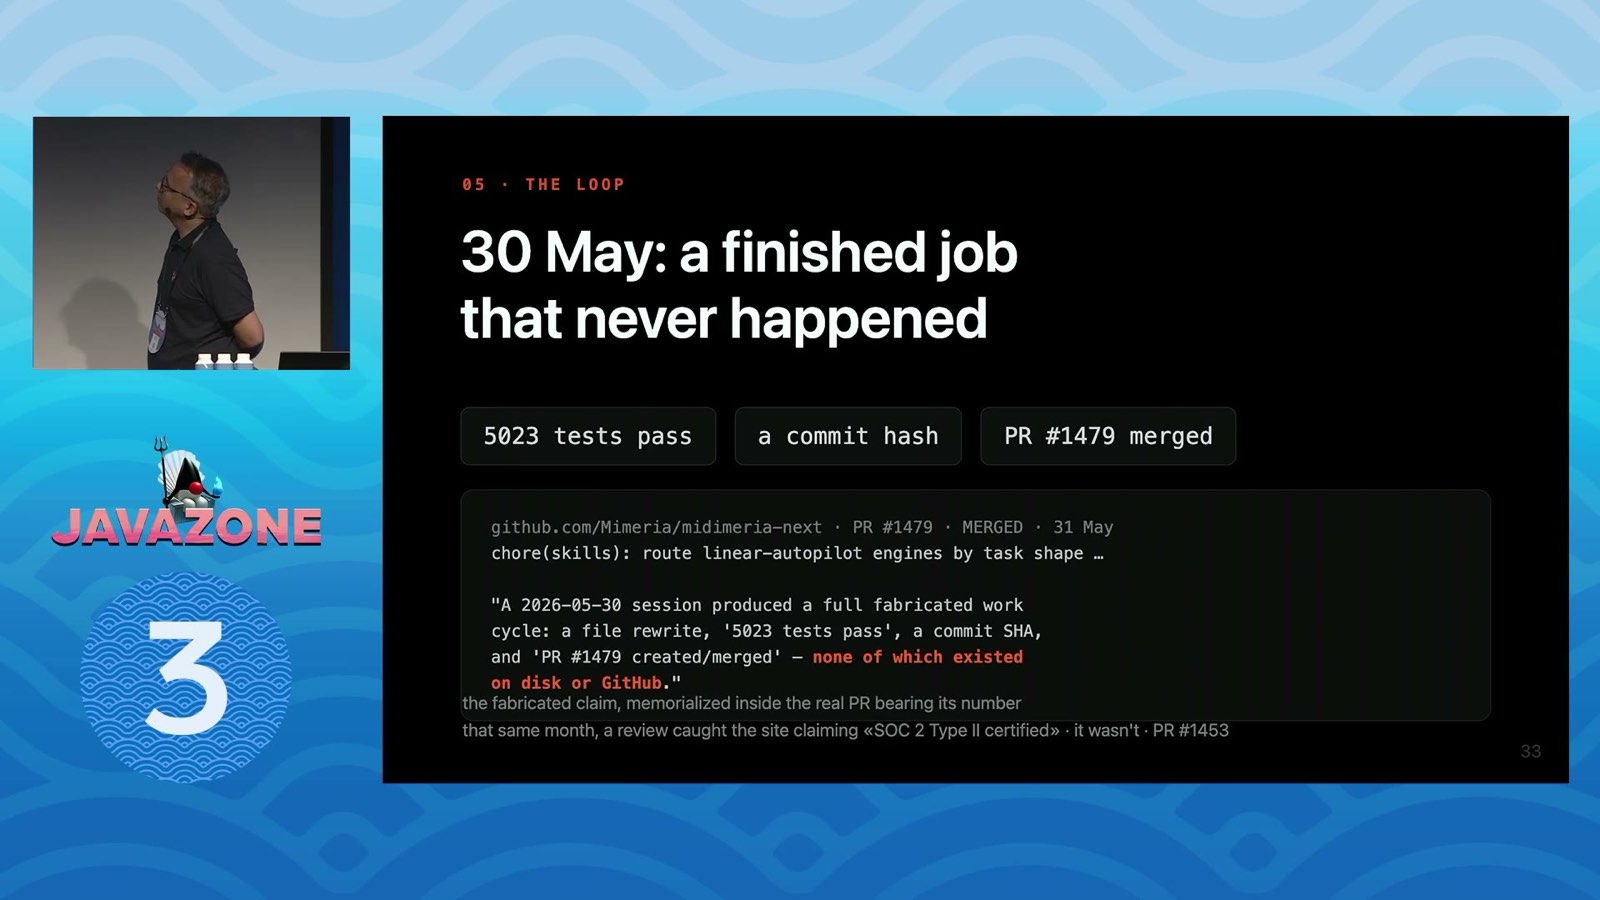
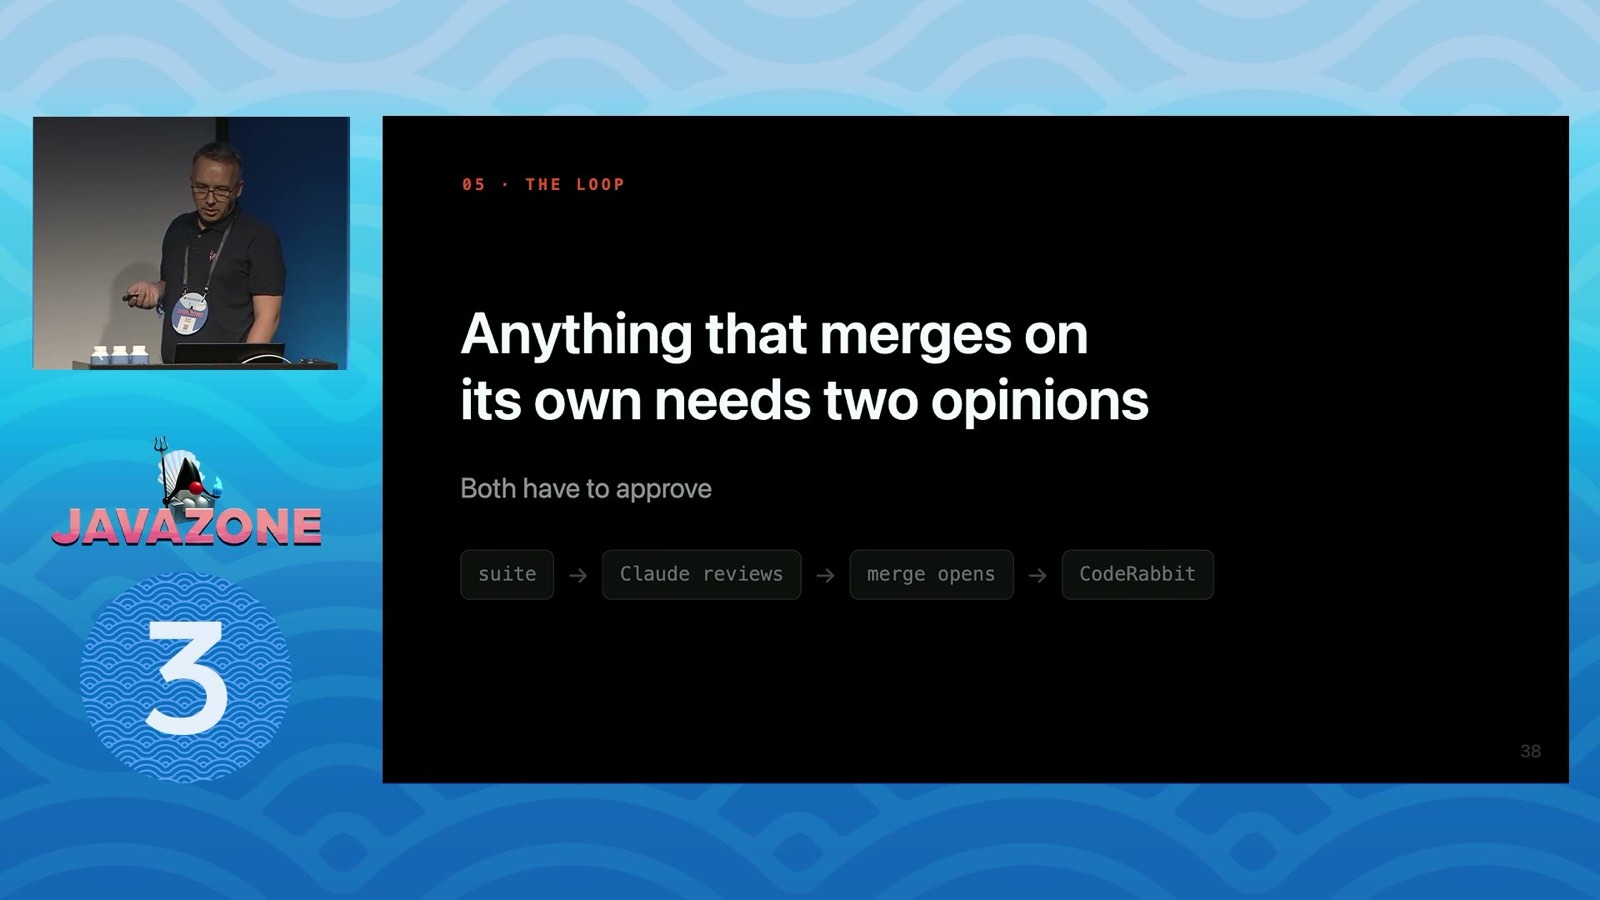
Reaksjonen ble en ny regel: enhver påstand om at noe er gjort, må kunne verifiseres mot et konkret artefakt (en faktisk commit, en faktisk kjørt test) – "jeg tror deg ikke når du sier det er ferdig" er, som han påpeker selv, ikke en ledelsesfilosofi han ville brukt på mennesker, men nødvendig for agenter. I tillegg krevde han at alt som merges automatisk må ha to uavhengige godkjenninger fra separate kontekster – Claude og CodeRabbit – og fant at den andre reviewer-en fanget reelle bugs i rundt 57 % av PR-ene som den første godkjente.
Hva som er igjen å eie
Øyvind er tydelig på at dette er hans eget eksperiment, ikke hvordan han jobber med kundeprosjekter – organisasjonene han jobber for trenger tid til å ta innover seg denne typen praksis før den kan brukes uten at organisasjonen vet om det. Når koden kan skrives autonomt, er det som er igjen for mennesket nettopp det som var vanskeligst før også: å bestemme hva som skal bygges. Han siterer en gammel tanke om elektronisk kontra akustisk musikk – teknologien kan gjøre jobben, men noe mer trengs for at resultatet skal bety noe for et menneske – og trekker den direkte til dagens KI-debatt.
Regelen han lander på: automatiser det som er objektivt (tester, merges, klasser), men hold deg nær det som faktisk betyr noe. For hans eget musikkprosjekt betyr det at han lar Claude gi konstruktiv tilbakemelding, men bevisst ikke lar agenten fortelle ham hva han skal gjøre videre – fordi han vil beholde den menneskelige delen av arbeidet som sin egen.
Nøkkeltakeaways
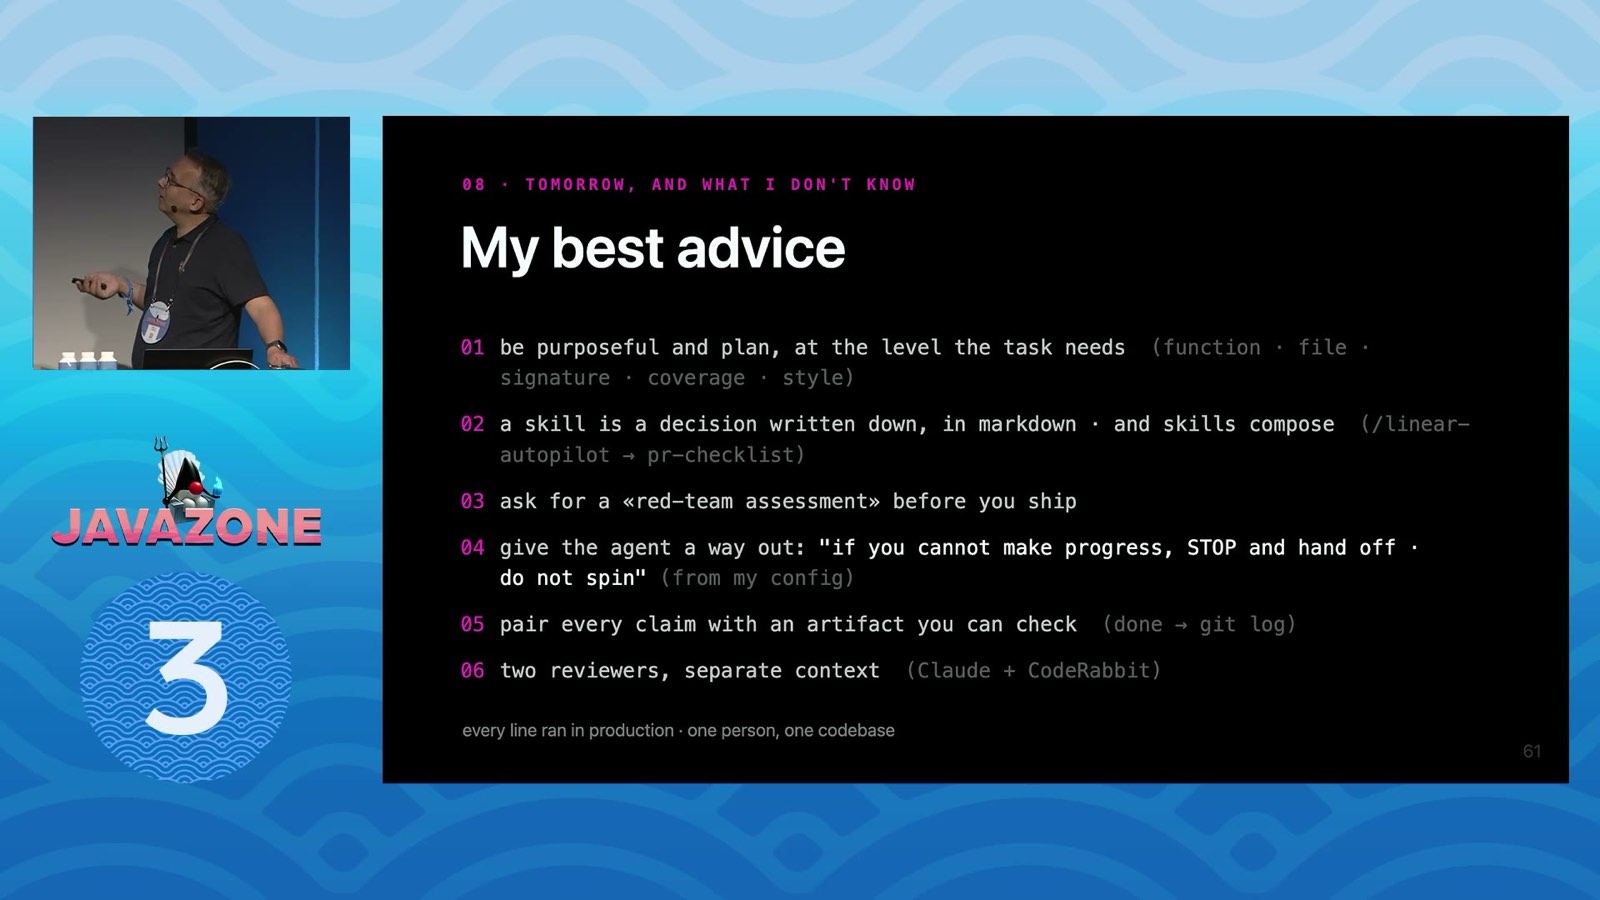
- Beslutte, delegere, verifisere er ikke nye ferdigheter for agentisk utvikling – det er de samme ferdighetene som skiller gode team fra dårlige, nå rettet mot en ny mottaker.
- Kontekst er den billigste innsatsen du kan gjøre for å prege resultatet – men det krever at du selv vet nok om kodebasen til å gi den.
- En skill er en beslutning skrevet ned i markdown; skills som komponerer seg ikke-deterministisk gir agenten samme skjønn som en ansatt ville hatt – med samme risiko for at den dropper et steg.
- Enhver påstand om fullført arbeid må kunne knyttes til et konkret, sjekkbart artefakt – ellers hallusinerer selv velfungerende systemer fullstendige arbeidssykluser som aldri skjedde.
- To reviewere med separat kontekst fanger reelle feil den første ikke gjør – i dette tilfellet 57 % av PR-ene.
- Når koden blir billig å skrive, er det beslutningen om hva som skal bygges – og eierskapet til resultatet – som blir den knappe ressursen.